In breve: I crawler delle IA sono i programmi con cui OpenAI, Google, Anthropic, Perplexity e altri leggono i siti: alcuni raccolgono testi per addestrare i modelli, altri cercano fonti per rispondere agli utenti. Nel robots.txt puoi decidere chi far entrare. Se vuoi essere citato dagli assistenti, non bloccare almeno i crawler di ricerca.
Aprendo il robots.txt di un sito oggi si trovano spesso nomi come GPTBot, ClaudeBot o Google-Extended, a volte bloccati senza che il proprietario lo sappia: li ha aggiunti un plugin, un tema o il firewall dell’hosting. E un sito che blocca i crawler sbagliati non può essere letto dagli assistenti che dovrebbero citarlo.
In questa guida trovi i crawler principali, cosa fa ciascuno e come scegliere. È uno dei primi controlli tecnici che faccio nella SEO per l’IA.
Tre tipi di crawler, tre scelte diverse
- Crawler di addestramento: raccolgono testi pubblici per addestrare i modelli. Bloccarli non toglie il sito dalle ricerche degli assistenti, ma limita l’uso dei tuoi testi per i modelli futuri.
- Crawler di ricerca: leggono le pagine per mostrarle come fonti nelle risposte, con il link. Bloccarli significa, in pratica, rinunciare a essere citato da quell’assistente.
- Visite su richiesta dell’utente: quando una persona chiede all’assistente di aprire una pagina precisa. Alcuni gestori precisano che per queste visite il robots.txt potrebbe non essere applicato, perché l’azione è chiesta da una persona.
I principali crawler delle IA
| Gestore | Nome (user agent) | A cosa serve |
|---|---|---|
| OpenAI | GPTBot | Addestramento dei modelli |
| OpenAI | OAI-SearchBot | Ricerca in ChatGPT: fonti e link nelle risposte |
| OpenAI | ChatGPT-User | Pagine aperte su richiesta dell’utente |
| Anthropic | ClaudeBot | Addestramento dei modelli |
| Anthropic | Claude-SearchBot / Claude-User | Ricerca e pagine aperte su richiesta dell’utente |
| Perplexity | PerplexityBot / Perplexity-User | Indice di ricerca e pagine aperte su richiesta |
| Googlebot | Ricerca Google, comprese AI Overviews e AI Mode | |
| Google-Extended | Non è un crawler a parte: è un nome da usare nel robots.txt per decidere se i contenuti possono servire a Gemini fuori dalla Ricerca | |
| Apple | Applebot-Extended | Come Google-Extended, per l’uso nei modelli di Apple |
| Common Crawl | CCBot | Archivio pubblico del web, usato anche per addestrare modelli |
I nomi cambiano e se ne aggiungono di nuovi: prima di modificare il robots.txt controlla le pagine ufficiali, per esempio quella di OpenAI sui suoi crawler e quella di Google sui suoi crawler. Copilot di Microsoft si appoggia in gran parte all’indice di Bing, quindi conta anche non bloccare Bingbot.
Bloccare o no?
Non c’è una risposta valida per tutti. Dipende da cosa vende il sito:
| Tipo di sito | Scelta che di solito consiglio |
|---|---|
| Attività locale, professionista, azienda di servizi | Lasciare entrare tutti: essere conosciuti e citati conta più che proteggere i testi |
| E-commerce | Lasciare entrare almeno i crawler di ricerca; valutare quelli di addestramento |
| Editore, blog che vive di pubblicità, contenuti a pagamento | Valutare con attenzione: bloccare l’addestramento, lasciare la ricerca se porta visite |
Per una piccola attività bloccare tutto è quasi sempre controproducente: l’obiettivo è che gli assistenti sappiano chi sei e mandino clienti, non nascondersi.
Esempi di robots.txt
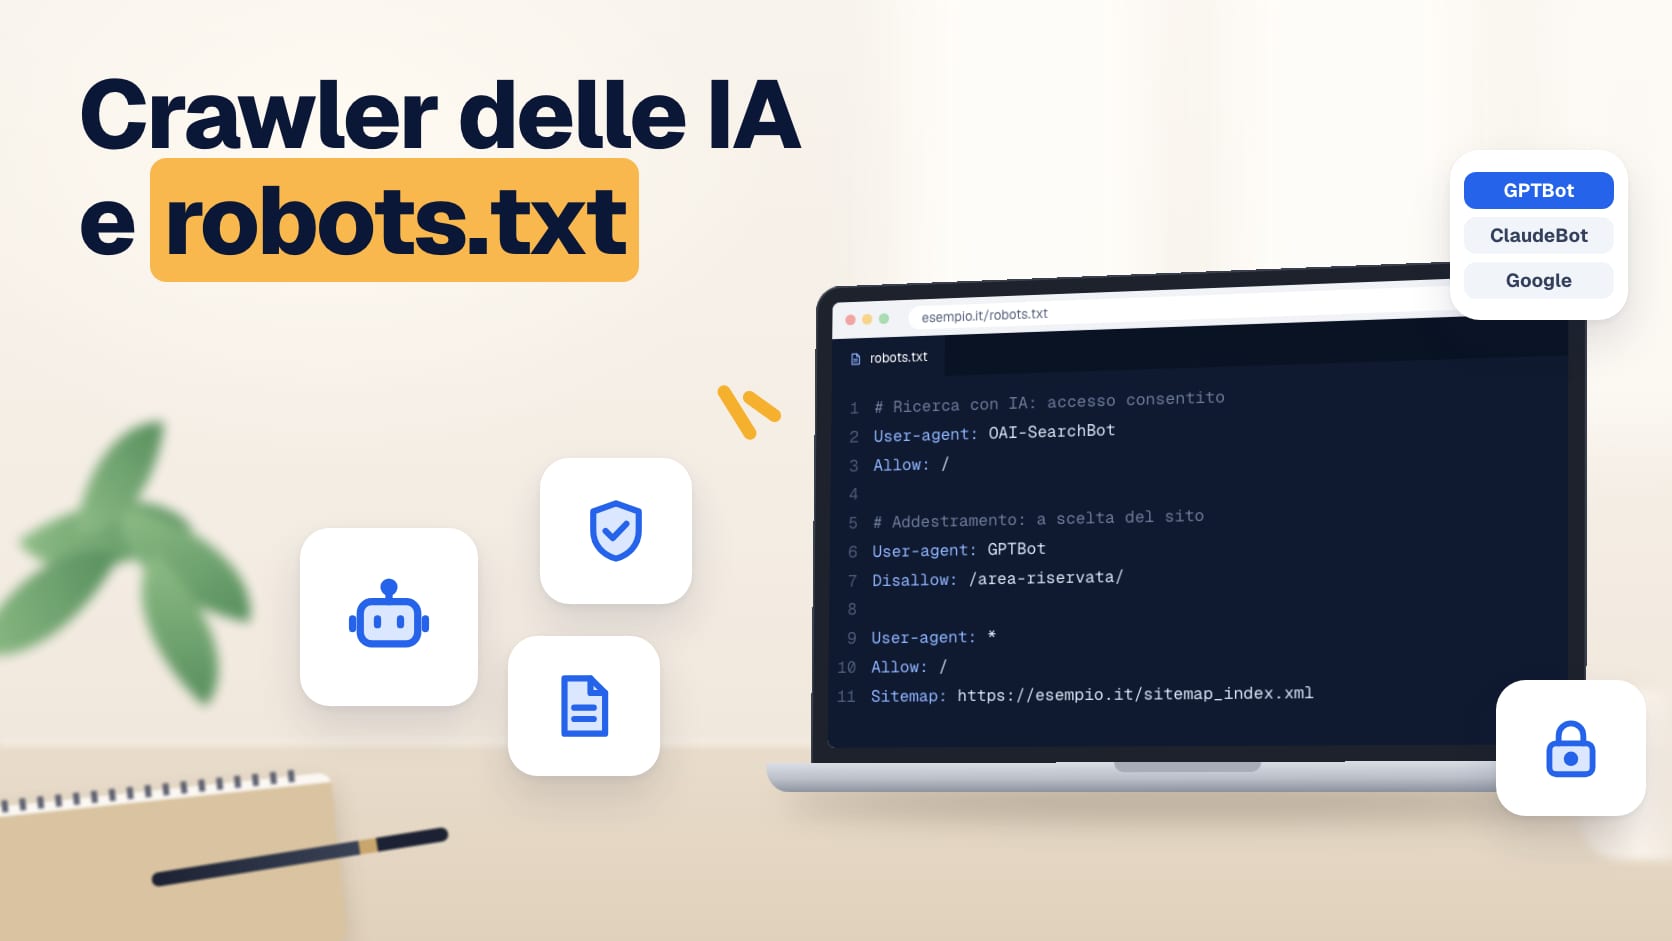
Se non scrivi nessuna regola per un crawler, vale la regola generale User-agent: *. Un robots.txt che lascia entrare tutti, tranne l’area amministrativa di WordPress, è semplicemente questo:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://www.tuosito.it/sitemap_index.xml
Se invece vuoi lasciare la ricerca degli assistenti ma non l’addestramento dei modelli, puoi bloccare solo i crawler di addestramento:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://www.tuosito.it/sitemap_index.xml
Attenzione a non bloccare per errore Googlebot o OAI-SearchBot: il primo ti toglie da Google, comprese le AI Overviews di cui parlo nella guida sulle AI Overviews di Google, il secondo dalle fonti di ChatGPT.
Cosa succede se blocchi i crawler di ricerca
Se blocchi OAI-SearchBot, ChatGPT non può leggere le tue pagine quando cerca fonti per una risposta: potrà ancora parlare di te usando altre fonti (directory, recensioni, siti di terzi), ma senza citare il tuo sito e senza il link che porta visite. Lo stesso vale per i crawler di ricerca di Anthropic e Perplexity con i rispettivi assistenti.
Il blocco non ha effetto immediato su ciò che i modelli hanno già imparato, e sbloccare non porta citazioni dall’oggi al domani: i crawler devono tornare sul sito, e le risposte dipendono comunque dalla qualità delle pagine. Per questo conviene decidere una volta, con calma, e non cambiare idea ogni mese.
Gli errori più frequenti nel robots.txt
- Un Disallow: / sotto User-agent: * lasciato dopo la messa online: blocca tutti, Google compreso. Succede spesso con i siti nati in un ambiente di prova.
- Regole copiate da un altro sito, con percorsi che nel tuo non esistono o, peggio, che bloccano cartelle di immagini, CSS e JavaScript.
- Nomi scritti male: un crawler con il nome sbagliato non viene riconosciuto e la regola non vale.
- Pensare che il robots.txt nasconda una pagina: impedisce la scansione, non l’indicizzazione. Per togliere una pagina da Google serve il meta tag noindex.
- Due file in conflitto: uno generato dal plugin SEO e uno caricato a mano, con regole diverse.
Come controllare cosa succede sul tuo sito
- apri
tuosito.it/robots.txtnel browser e leggi chi è bloccato; - controlla le impostazioni del plugin SEO e dei plugin di sicurezza, che a volte aggiungono regole sui bot;
- controlla il firewall o la CDN: servizi come Cloudflare hanno un’opzione per bloccare i bot delle IA, in alcuni casi attiva di default;
- guarda i log del server (o chiedi all’hosting) per vedere quali crawler visitano il sito e con quali risposte;
- dopo ogni modifica, ripeti il controllo: un robots.txt sbagliato può fare danni anche alla SEO classica.
Il robots.txt non basta: controlla anche l’hosting
Un robots.txt corretto non serve se il server blocca i bot prima ancora di leggerlo. Mi è successo con questo sito: dopo la migrazione, il controllo con curl ha mostrato che il filtro anti-bot dell’hosting rispondeva 429 Too Many Requests a GPTBot, ClaudeBot e PerplexityBot, perfino sulla richiesta del robots.txt. Il file era giusto, ma quei crawler non potevano leggere nulla.
La prova si fa in un minuto da terminale, cambiando il nome del bot: curl -s -o /dev/null -w "%{http_code}" -A "GPTBot/1.2" https://www.tuosito.it/robots.txt. Se la risposta non è 200, chiedi all’assistenza dell’hosting di togliere quei bot dalla protezione anti-bot.
robots.txt e llms.txt: non confonderli
Il robots.txt decide chi può entrare. Il file llms.txt, invece, è un riassunto del sito per i modelli linguistici e non contiene regole di accesso: scriverci dentro Disallow non blocca nessuno. Se vuoi capire come si scrive, leggi la guida su cos’è llms.txt e come crearlo.
Come lavoro sui siti che seguo
Sui siti che curo per la SEO per l’IA, come quelli di NIU Art Law e Amico Straniero, il primo controllo è che i crawler di ricerca possano leggere le pagine: robots.txt, plugin e hosting. Poi passo ai contenuti e ai dati strutturati. La scelta sui crawler di addestramento la prendo insieme al cliente, spiegando cosa comporta. Per la parte di posizionamento classico resta valida la consulenza SEO.
Domande frequenti sui crawler delle IA
Se blocco GPTBot sparisco da ChatGPT?
Non necessariamente. GPTBot serve all’addestramento; per le fonti delle risposte con ricerca ChatGPT usa OAI-SearchBot. Per essere citato non bloccare OAI-SearchBot.
Bloccare Google-Extended mi penalizza su Google?
No. Google-Extended non influisce sul posizionamento né sulla presenza nella Ricerca, comprese le AI Overviews: riguarda l’uso dei contenuti per Gemini fuori dalla Ricerca.
Il robots.txt è sufficiente per proteggere i miei contenuti?
No. È un’indicazione che i crawler seri rispettano, non una barriera. Chi non la rispetta va bloccato a livello di server o firewall.
Come faccio a sapere quali bot visitano il mio sito?
Dai log del server, che registrano il nome di ogni visitatore automatico. Molti hosting li mettono a disposizione nel pannello, oppure li puoi chiedere all’assistenza.
Ogni quanto va controllato il robots.txt?
Dopo ogni cambio di tema, plugin SEO, plugin di sicurezza o hosting, e comunque qualche volta l’anno: nascono nuovi crawler e cambiano le opzioni predefinite.
Armando FerrandinoWeb designer e sviluppatore dal 2009. Realizzo siti web ed e-commerce per aziende e professionisti e scrivo guide pratiche su siti, SEO e vendite online. Chi sono